هیچ محصولی در سبد خرید نیست.
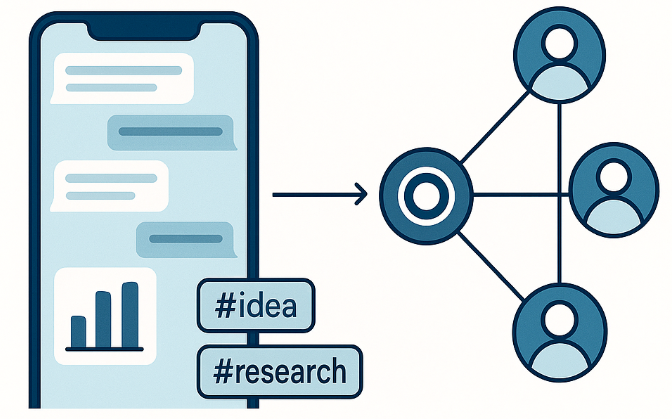
یکی از چالشهایی که در توسعه سیستم رصد پیامهای تلگرام با آن روبهرو شدم، تشخیص پیامهایی بود که واقعاً حاوی یک پیشنهاد پروژه، فرصت همکاری یا درخواست انجام کار هستند.
در نسخه اولیه، شناسایی این پیامها با استفاده از هشتگها و مجموعهای از کلمات کلیدی انجام میشد. این روش سرعت بالایی داشت و منابع بسیار کمی مصرف میکرد، اما بهتنهایی نمیتوانست مفهوم واقعی پیام را تشخیص دهد.
برای مثال، وجود کلماتی مانند «پروژه»، «طراح»، «برنامهنویس» یا «همکاری» لزوماً به معنای وجود یک فرصت کاری نیست. این کلمات ممکن است در یک گفتوگوی معمولی، تبلیغ دوره آموزشی، معرفی رزومه، پرسش فنی یا حتی پیام اسپم نیز استفاده شوند. از طرف دیگر، برخی پیامهای پروژهای بدون استفاده از همین کلمات نوشته میشوند:
«برای تکمیل یک پنل مدیریتی با جنگو، یک نفر مسلط نیاز داریم. شرایط در پیوی.»
این پیام ممکن است هشتگ مشخصی نداشته باشد، اما از نظر معنایی کاملاً یک فرصت پروژه یا همکاری است.
به همین دلیل، اتکا به هشتگ و کلیدواژه باعث ایجاد دو نوع خطا میشد:
اولین راهکاری که برای حل این مسئله به ذهن میرسید، ارسال تمام پیامها به یک مدل هوش مصنوعی بود. اما این رویکرد با اهداف فنی پروژه همخوانی نداشت.
استفاده از API مدلهای هوش مصنوعی، سیستم را به یک سرویس خارجی وابسته میکرد و با افزایش تعداد پیامها، هزینه پردازش نیز بیشتر میشد. اجرای مدلهای زبانی بزرگ بهصورت محلی نیز به رم و توان پردازشی قابل توجهی نیاز داشت؛ در حالیکه قرار بود این سرویس روی زیرساختی با منابع محدود اجرا شود.
پس بجای استفاده از یک مدل سنگین برای بررسی تمام پیامها، مسئله را به یک قیف پردازشی دو مرحلهای تبدیل کردم.
در مرحله اول، از قواعد ساده و سریع برای غربالکردن پیامها استفاده میشود. در مرحله دوم، تنها پیام هایی که احتمال پروژه ای بودن آن ها وجود دارد، وارد بخش تشخیص هوشمند میشوند.
در لایه اول، پیام ها با استفاده از ترکیبی از موارد زیر بررسی میشوند:
هدف این مرحله، تشخیص قطعی پروژه نیست. این فیلتر فقط باید پیامهایی را که به وضوح نامرتبط هستند کنار بگذارد و پیام های مشکوک را برای بررسی دقیق تر نگه دارد.
این تفکیک اهمیت زیادی دارد؛ چون اگر فیلتر اولیه بیش از حد سخت گیرانه باشد، فرصت های واقعی را حذف میکند. اگر بیش از حد آزاد باشد نیز حجم زیادی از پیامهای معمولی به مدل مرحله دوم ارسال میشود.
بنابراین، در این مرحله اولویت با Recall بالاتر است؛ یعنی بهتر است تعدادی پیام اضافی وارد مرحله بعد شوند تا اینکه یک فرصت واقعی در همان ابتدای مسیر از دست برود.
پیامهای عبور کرده از مرحله اول، توسط یک مدل طبقه بندی متن بررسی میشوند. وظیفه مدل این است که مشخص کند آیا پیام واقعاً شامل پروژه، پیشنهاد همکاری یا درخواست نیروی متخصص است یا صرفاً از کلمات مشابه استفاده کرده است.
برای این بخش، استفاده از مدل های زبانی بزرگی مانند Llama، Qwen یا مدل های اجرا شده با Ollama را مناسب ندیدم. این مدلها قابلیت های زیادی دارند، اما برای یک مسئله دودویی ساده مانند تشخیص «پروژه» و «غیرپروژه»، هزینه سخت افزاری و پیچیدگی غیرضروری ایجاد میکنند.
در واقع، مسئله اصلی این سیستم تولید متن یا درک چند مرحله ای زبان نیست؛ بلکه یک مسئله مشخص طبقه بندی متن است:
[
f(\text{message}) \rightarrow
\begin{cases}
\text{Project} \
\text{Non-Project}
\end{cases}
]
به همین دلیل، استفاده از یک مدل کوچک که روی پیام های واقعی همان گروه ها آموزش دیده باشد، میتواند نسبت به یک مدل عمومی و سنگین، انتخاب عملی تری باشد.
برای پیاده سازی این بخش، سه مسیر اصلی را بررسی کردم.
سبک ترین گزینه، استفاده از یک دسته بند بیزین بود. این روش منابع بسیار کمی مصرف میکند، سریع است و میتوان آن را مستقیماً با کتابخانههای Go پیادهسازی کرد.
مزیت اصلی این گزینه، سادگی استقرار و نبود وابستگی به سرویس یا Runtime جانبی است. بااینحال، مدل بیزین بیشتر بر فراوانی کلمات تکیه دارد و در درک ساختار پیچیدهتر جمله و ارتباط معنایی میان واژهها محدودیت دارد.
این روش میتواند بهعنوان نقطه شروع یا Baseline استفاده شود، اما احتمالاً برای پیامهای مبهم و محاورهای به داده آموزشی بیشتر و پیش پردازش دقیق تری نیاز خواهد داشت.
گزینه دوم، استفاده از FastText بود. این مدل علاوه بر کلمات، از زیرواژه ها و n-gram های کاراکتری نیز استفاده میکند.
این ویژگی برای پیام های فارسی تلگرام اهمیت زیادی دارد؛ چون کاربران ممکن است یک کلمه را با فاصله گذاری متفاوت، نیم فاصله، غلط املایی یا شکل های عامیانه بنویسند. برای مثال، عبارتهای زیر ممکن است از نظر ظاهری متفاوت باشند، اما معنای مشابهی داشته باشند:
FastText بهدلیل ساختار زیرواژهای خود، در برابر بخشی از این تفاوت ها مقاومتر است و درعینحال سرعت بالا و مصرف منابع نسبتاً کمی دارد. به همین دلیل، این گزینه برای نسخه عملی اولیه، توازن مناسبی میان سرعت، دقت و هزینه ایجاد میکند.
گزینه سوم، استفاده از یک مدل کوچک ترنسفورمری و اجرای آن با ONNX Runtime بود. این مسیر میتواند در تشخیص معنای جمله دقت بیشتری ارائه دهد، اما نسبت به دو گزینه قبلی، رم بیشتری مصرف میکند و فرآیند آماده سازی مدل، Tokenizer و استقرار آن پیچیدهتر است.
این گزینه زمانی منطقی تر میشود که داده آموزشی کافی جمع آوری شده باشد و نتایج FastText نشان دهد که برای پیامهای مبهم به درک معنایی بیشتری نیاز داریم.
یکی از نتایج مهم این بررسی این بود که انتخاب کتابخانه بهتنهایی، دقت سیستم را تضمین نمیکند. مهمترین بخش این فرایند، تهیه یک دیتاست واقعی از همان گروه هایی است که سیستم قرار است آن ها را رصد کند.
زبان پیام های تلگرام معمولاً رسمی و استاندارد نیست. کاربران از شکلهای مختلف نوشتاری، اصطلاحات عامیانه، غلطهای تایپی، ایموجی و عبارتهای کوتاه استفاده میکنند. بنابراین، مدلی که با متنهای رسمی آموزش دیده باشد، الزاماً روی پیامهای واقعی گروه ها عملکرد مطلوبی نخواهد داشت.
برای شروع، پیامها در دو گروه اصلی برچسب گذاری میشوند:
Project: پیشنهاد پروژه، استخدام، همکاری یا درخواست انجام کارNon-Project: گفت و گوی معمولی، تبلیغات، معرفی رزومه، سؤال فنی، اسپم و سایر پیامهاالبته برای افزایش دقت، دسته دوم باید شامل نمونه های دشوار نیز باشد؛ برای مثال، پیامهایی که کلمات «پروژه» یا «همکاری» را دارند، اما درواقع فرصت کاری نیستند. این نمونه ها به مدل کمک میکنند صرفاً با مشاهده یک کلمه خاص، پیام را پروژهای تشخیص ندهد.
برای نسخه ابتدایی، تصمیم گرفتم سیستم را با یک مدل سبک مانند FastText و یک دیتاست کوچک از پیامهای واقعی آغاز کنم.
مدل ابتدا روی سیستم شخصی آموزش داده میشود و فایل نهایی آن روی سرور قرار میگیرد. در زمان اجرا، سرویس فقط عملیات پیشبینی را انجام میدهد و نیازی به آموزش مجدد، ارتباط با API یا استفاده از GPU ندارد.
خروجی مدل نیز فقط یک برچسب ساده نیست؛ بلکه یک امتیاز اطمینان برای پروژهایبودن پیام تولید میشود:
[
P(\text{Project}\mid \text{Message})
]
براساس این امتیاز، پیامها به سه گروه تقسیم میشوند:
پیامهایی که توسط ادمین تأیید یا رد میشوند نیز میتوانند دوباره به دیتاست اضافه شوند. به این ترتیب، سیستم بهمرور با ادبیات واقعی گروهها سازگارتر میشود.
این طراحی چند مزیت مهم برای سیستم ایجاد میکند:
در این مسئله، هدف استفاده از بزرگترین مدل هوش مصنوعی نبود. هدف، طراحی مسیری بود که ابتدا با قواعد ساده، دامنه جستوجو را محدود کند و سپس با یک مدل کوچک و تخصصی، تصمیم دقیقتری بگیرد.
گاهی برای اضافهکردن هوش مصنوعی به یک سیستم، به مدلهای چندمیلیارد پارامتری نیاز نداریم؛ یک طبقهبند کوچک که با داده درست آموزش دیده باشد، میتواند با هزینه کمتر، سرعت بیشتر و معماری سادهتر، دقیقاً همان مسئله موردنیاز پروژه را حل کند.
#چالرشته

دیدگاه کاربران